
De la vérification à l’alerte, un même parcours.
Planifiez le contrôle d’un service, examinez sa réponse et envoyez une notification Discord lorsque votre règle d’alerte est remplie.
Pour les équipes IT, plateforme et exploitation.
Le besoin, sur le terrain.
Les vérifications régulières se répartissent entre commandes manuelles et scripts isolés. Quand une réponse semble anormale, il faut retrouver le contrôle concerné avant de prévenir l’équipe.
- Une vérification faite uniquement à la main laisse des périodes sans contrôle.
- Un statut dégradé sans nom de service ni contexte oblige l’équipe à recommencer le diagnostic.
- Un contrôle réussi ne doit pas produire la même notification qu’un service réellement en difficulté.
Exemple : surveiller l’état d’une application interne
Interrogez périodiquement l’endpoint de santé de votre application. Si la réponse indique un état dégradé, transmettez à votre canal Discord le service concerné et les informations renvoyées.
- Sans workflow
- Un script vérifie un endpoint, puis une personne lit la réponse et décide de prévenir l’équipe.
- Avec nodulz
- Le contrôle périodique et la décision d’alerter sont visibles dans un workflow ; la branche normale se termine sans notification.
Comment nodulz règle le problème.
nodulz met la vérification et la règle d’alerte dans le même parcours. Le workflow distingue un état dégradé d’une réponse normale avant de solliciter l’équipe.
Interroger le même signal
Le nœud HTTP appelle l’endpoint de santé de votre application. Le contrat de réponse est défini par votre service, par exemple un champ status qui vaut ok ou degraded.
Décider avant de notifier
Le nœud Condition examine ce statut. Sa branche vraie mène à l’alerte ; sa branche fausse conserve le résultat normal sans solliciter le canal de l’équipe.
Transmettre un contexte utile
La notification Discord réutilise le nom du service, le statut et les informations renvoyées. Les logs de l’exécution permettent de retrouver le contrôle qui a produit cette décision.
Du déclencheur au résultat.
Planification · Requête HTTP · Condition · Discord
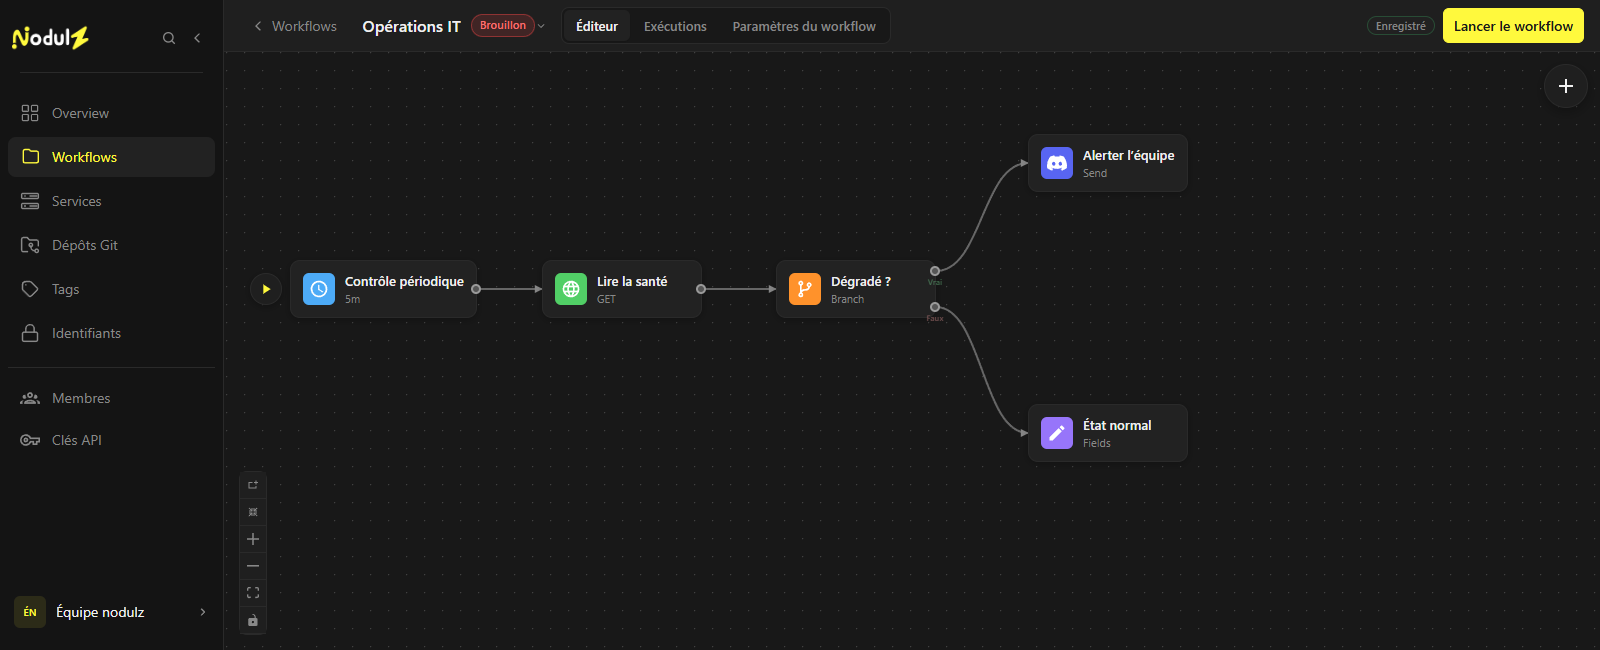
Les deux branches distinguent l’alerte de l’état normal. Capture de l’éditeur avec un workflow d’exemple non exécuté.
Faites défiler la capture horizontalement pour suivre tout le workflow.
Ce qui se passe, étape par étape.
- 1
Contrôle périodique
Choisissez la fréquence de contrôle adaptée à votre application.
- Données utilisées
- Fréquence retenue par l’équipe, par exemple un contrôle toutes les cinq minutes.
- Ce que l’étape transmet
- Le déclenchement d’une vérification du service.
- 2
Lire la santé
Appelez l’endpoint de santé et récupérez son contenu. Configurez aussi le comportement en cas d’erreur réseau.
- Données utilisées
- Endpoint de santé et paramètres du contrôle HTTP.
- Ce que l’étape transmet
- Réponse du service, par exemple son nom et un statut ok ou degraded.
- 3
Service dégradé ?
Comparez le statut reçu au critère défini par votre équipe pour ouvrir la branche d’alerte.
- Données utilisées
- Statut de la réponse et condition définie par l’équipe.
- Ce que l’étape transmet
- Branche vraie : alerter. Branche fausse : conserver un état normal sans envoyer de message.
- 4
Alerter l’équipe
Envoyez le nom du service, son état et les informations utiles au diagnostic.
- Données utilisées
- Nom du service et détails du contrôle ayant signalé une dégradation.
- Ce que l’étape transmet
- Une demande de notification envoyée au webhook Discord configuré.
Workflow d’exemple : adaptez les connexions, les paramètres et les règles à votre environnement. Les données montrées sont illustratives.
Ce que ce workflow apporte.
Les contrôles et leur règle d’alerte deviennent lisibles dans un même workflow. La notification reprend les données du contrôle pour donner un point de départ au diagnostic.
- Une règle d’alerte explicite, visible à côté du contrôle.
- Une notification liée à une réponse précise et à son service.
- Un parcours normal qui ne crée pas de bruit dans le canal de l’équipe.
Gardez la main sur le processus.
Fixez les délais d’attente et la fréquence des alertes selon votre service. La gestion d’une absence de réponse et la limitation des notifications doivent être configurées pour votre contexte.
Explorer les nœuds disponibles