
Modèle, outils et mémoire
Choisissez son modèle, rattachez les outils qu’il peut appeler et ajoutez une mémoire si la conversation doit se poursuivre. Vous définissez les ressources mises à sa disposition.
Orchestrez vos API, traitements de données et agents IA dans un même environnement. Composez les workflows visuellement, étendez-les en code et inspectez chaque exécution.
Construisez des workflows à partir de triggers, de conditions et de sous-workflows. Le graphe expose les dépendances et les branches ; chaque nœud conserve sa configuration.
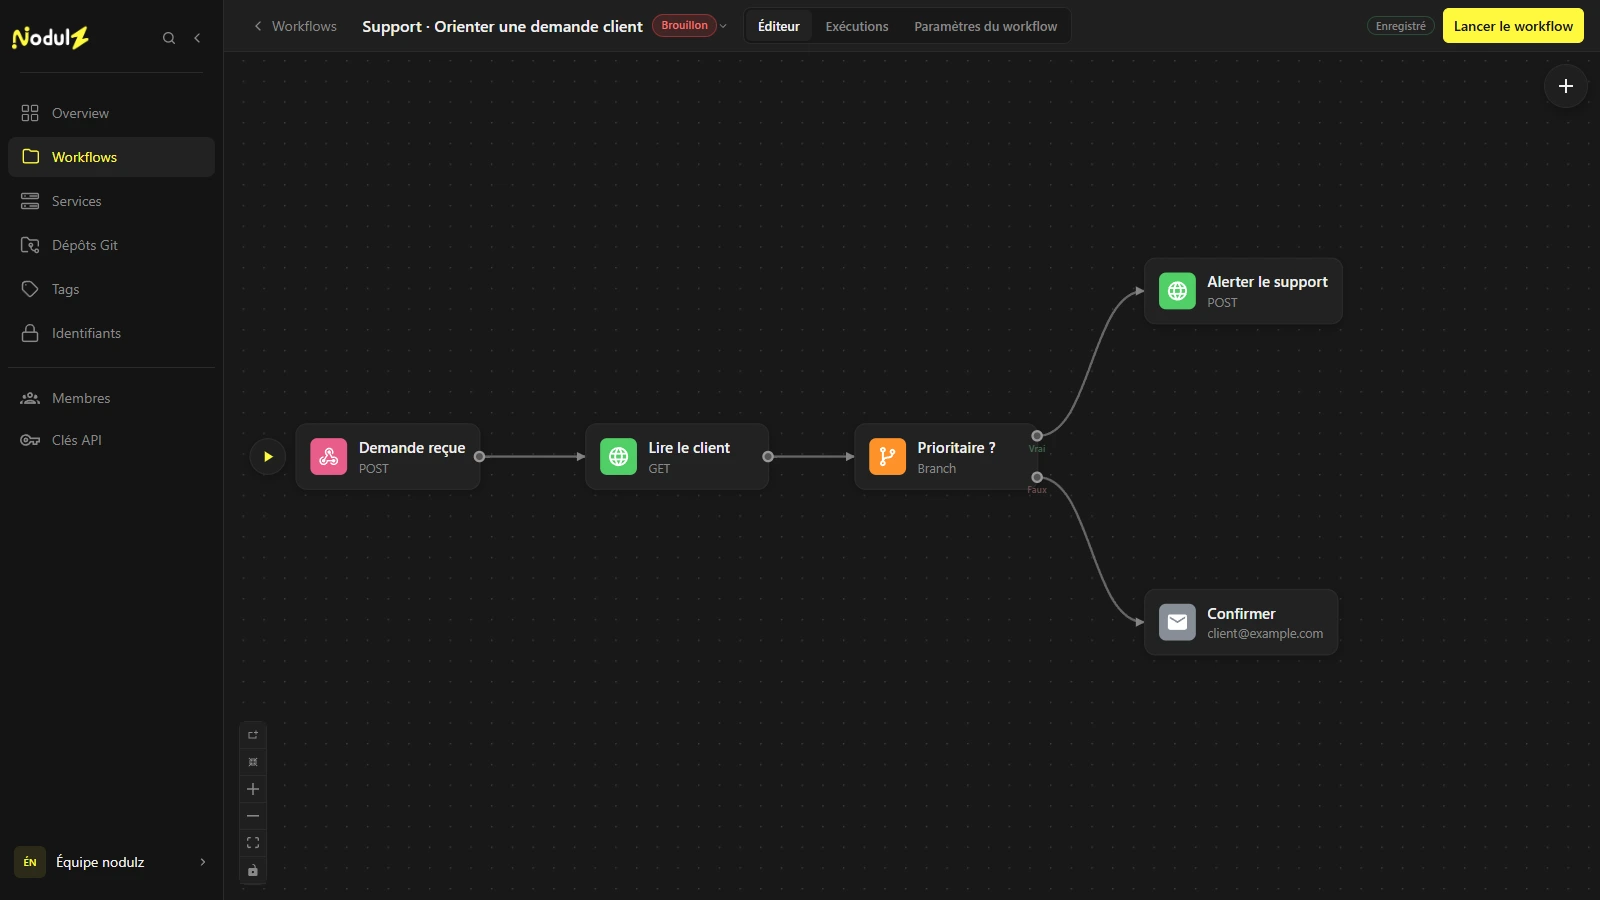
Webhook, planification, événement Git ou lancement manuel. Reliez les traitements, définissez les conditions et factorisez la logique dans des workflows réutilisables.
Combinez requêtes HTTP, accès aux bases de données et transformations en JavaScript ou Python. Vos scripts peuvent aussi provenir d’un dépôt Git, être encapsulés dans un conteneur et exécutés sur l’hôte, un serveur Docker distant ou dans Kubernetes. Leur orchestration reste dans le même workflow.
const records = input.map(record => ({
  ...record,
  status: record.status.toLowerCase()
}));

return records;[{ "status": "ACTIVE" }][{ "status": "active" }]Associez un modèle, des outils et une mémoire à un agent. Composez des pipelines RAG avec chargement de documents, découpage et recherche vectorielle.
Choisissez son modèle, rattachez les outils qu’il peut appeler et ajoutez une mémoire si la conversation doit se poursuivre. Vous définissez les ressources mises à sa disposition.
Chargez et découpez vos documents, puis interrogez un store vectoriel pour injecter les passages pertinents dans le contexte de l’agent.
Exécutez un nœud, une chaîne ou le workflow complet. Analysez les entrées, sorties et logs dans l’historique, puis configurez les politiques de reprise.
{
  "destination": "support",
  "priority": "high"
}Destination de notification invalide.
Exécutez un nœud avec une entrée de test, une chaîne de nœuds ou le graphe complet. Validez les transformations et connexions avant une exécution complète.
Inspectez le parcours, les résultats et les logs de chaque nœud. Localisez une erreur et analysez les données reçues par l’étape concernée.
Configurez les tentatives supplémentaires et le comportement en cas d’échec : arrêt, poursuite ou traitement de l’erreur dans le workflow.
Déployez bases de données, caches et stores vectoriels depuis le catalogue. Configurez les instances sur Docker ou Kubernetes et utilisez-les dans les nœuds compatibles.
PostgreSQL · Docker
Redis · Docker
Qdrant · Kubernetes
Choisissez une base de données, un cache ou une base vectorielle, puis une cible Docker ou Kubernetes. Configurez votre instance et ses identifiants depuis nodulz.
Consultez l’état des instances et leurs logs. Ajustez leur configuration et lancez un redéploiement depuis le même espace.
Utilisez vos instances de services dans les nœuds compatibles. Les connexions aux bases de données et aux bases vectorielles s’intègrent à vos traitements et à vos agents IA.
Centralisez workflows et services. Partagez les ressources avec votre équipe et contrôlez les accès par rôles et permissions.
Factorisez les traitements communs et appelez un workflow depuis plusieurs automatisations.
Gérez les accès aux workflows et aux services avec les rôles et permissions des ressources.
Guides et référence technique : prochainement sur nodulz.com/docs.
Distribution prochainement disponible.
Des premiers workflows à la collaboration en équipe, découvrez les formules nodulz et les modalités de licence.