
Vos données à jour, sans les recopier.
Récupérez les données d’une API, préparez les champs utiles et alimentez PostgreSQL dans un workflow planifié.
Pour les équipes data, intégration et opérations.
Le besoin, sur le terrain.
Votre outil de gestion expose des données par API, mais le reporting repose encore sur des exports manuels. Les formats diffèrent et chaque mise à jour exige les mêmes manipulations.
- Les exports manuels créent un décalage entre le catalogue métier et la base de reporting.
- Une référence ou un prix mal formaté peut fausser les rapprochements entre systèmes.
- En cas d’erreur, un fichier final ne dit pas si le problème vient de l’API, de la préparation ou de l’écriture en base.
Exemple : un catalogue produit pour le reporting
Chaque matin, récupérez les produits de votre outil métier. Harmonisez les références et les prix, puis mettez à jour la table utilisée par votre reporting interne.
- Sans workflow
- Une personne télécharge le catalogue, corrige les colonnes et importe le fichier dans la base à chaque mise à jour.
- Avec nodulz
- Un horaire déclenche la même chaîne de récupération, de normalisation et d’écriture ; les étapes peuvent être inspectées séparément.
Comment nodulz règle le problème.
nodulz relie votre source et votre base sans cacher la transformation entre les deux. L’équipe définit un contrat de données, puis assemble les nœuds qui le mettent en œuvre.
Un point de départ prévisible
Le nœud Planification donne le rythme. La requête HTTP précise l’endpoint, l’authentification et les paramètres utilisés pour obtenir le catalogue ; vous pouvez faire évoluer la source sans réécrire la suite.
Des champs alignés sur votre base
Le nœud Champs prépare les références, les libellés et les prix attendus par PostgreSQL. Les expressions utilisent les données des étapes précédentes, ce qui rend chaque correspondance explicite.
Une écriture contrôlée
La requête PostgreSQL applique votre règle d’insertion ou de mise à jour. Une clé unique et une stratégie de rapprochement sont définies côté base pour éviter de recréer un produit lors du prochain passage.
Du déclencheur au résultat.
Planification · Requête HTTP · Champs · PostgreSQL
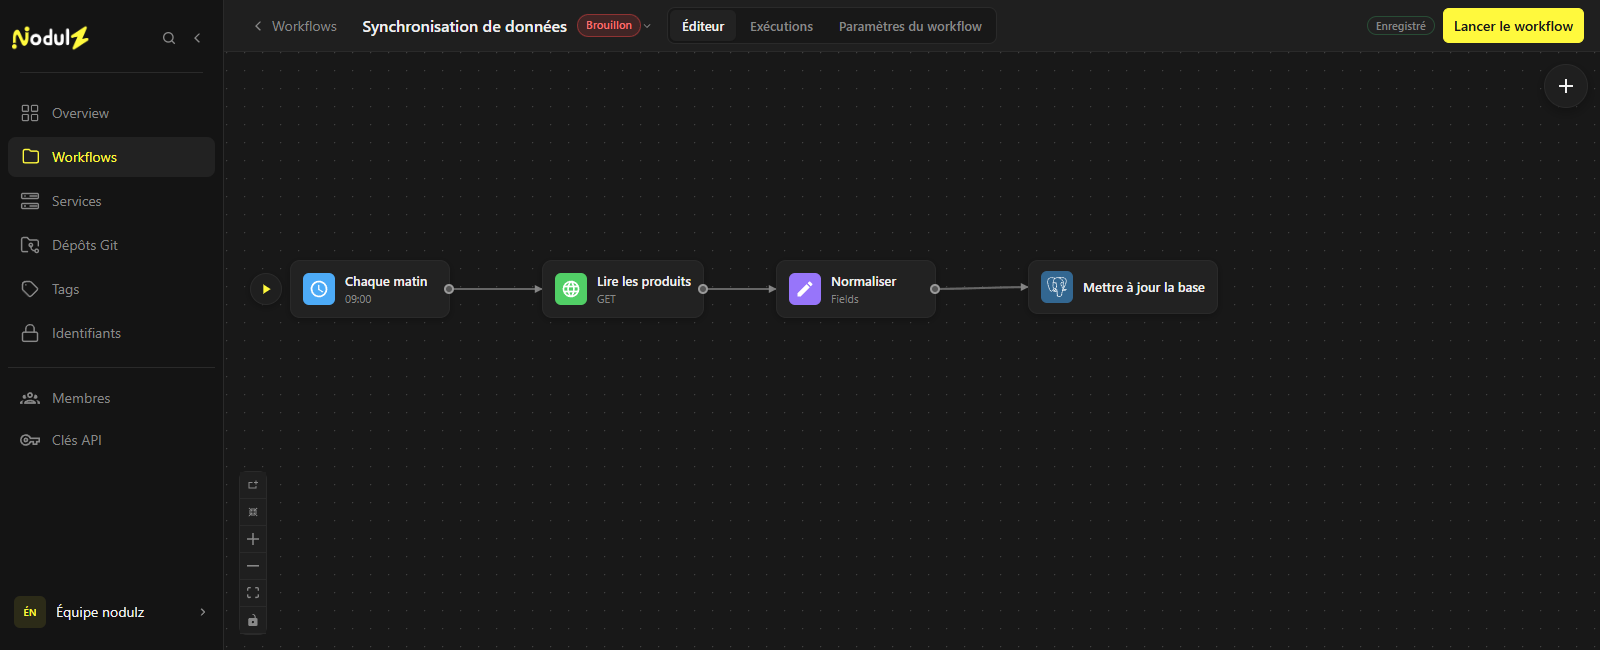
Le catalogue suit une chaîne lisible jusqu’à PostgreSQL. Capture de l’éditeur avec un workflow d’exemple non exécuté.
Faites défiler la capture horizontalement pour suivre tout le workflow.
Ce qui se passe, étape par étape.
- 1
Chaque matin
Définissez l’horaire de récupération selon le rythme de mise à jour de votre source.
- Données utilisées
- Horaire et fuseau définis pour le reporting, par exemple 09:00, Europe/Paris.
- Ce que l’étape transmet
- Une nouvelle exécution qui démarre la récupération du catalogue.
- 2
Lire les produits
Interrogez l’API du catalogue avec ses paramètres et son authentification.
- Données utilisées
- URL de l’API, credentials et paramètres de récupération.
- Ce que l’étape transmet
- Les références et attributs des produits renvoyés par l’API.
- 3
Normaliser
Sélectionnez et renommez les champs pour respecter le format de votre table cible.
- Données utilisées
- Données brutes : référence, nom et prix de chaque produit.
- Ce que l’étape transmet
- Les champs attendus par la table cible, par exemple sku, label et unit_price.
- 4
Mettre à jour la base
Écrivez une requête paramétrée pour insérer ou mettre à jour les produits par référence.
- Données utilisées
- Champs normalisés et règle de rapprochement par référence.
- Ce que l’étape transmet
- Résultat de la requête SQL ; la table produit peut ensuite être utilisée par le reporting.
Workflow d’exemple : adaptez les connexions, les paramètres et les règles à votre environnement. Les données montrées sont illustratives.
Ce que ce workflow apporte.
La récupération et la préparation suivent le même parcours à chaque exécution. Votre équipe peut retrouver les données entrantes et identifier l’étape qui nécessite une correction.
- Un format de données commun entre la source et le reporting.
- Une récupération régulière qui ne dépend plus d’un export manuel.
- Un diagnostic par étape plutôt qu’une recherche dans un fichier final.
Gardez la main sur le processus.
La clé de rapprochement et la requête SQL restent explicites. Prévoyez la pagination de l’API et une contrainte d’unicité en base pour adapter ce scénario à vos volumes.
Explorer les nœuds disponibles